Малоценные и маловостребованные страницы в Яндексе: что это, откуда берутся и как вернуть их в поиск
Статус «Малоценная или маловостребованная страница» в Вебмастере — не санкция, а решение алгоритма не держать страницу в поиске: она дублирует другую, робот не видит в ней контент или под неё нет запросов. По справке Яндекса, число таких страниц на ранжирование сайта не влияет, а квот на индекс нет. Чтобы вернуть нужную страницу, устраните причину — склейте дубль, отдайте текст в HTML или доработайте страницу под реальный спрос — и отправьте её на переобход: алгоритм пересматривает ту копию страницы, которая уже лежит в базе.
Что говорит справка Яндекса
Официальная позиция умещается в несколько фраз справки Вебмастера. Их полезно знать дословно: из них следует почти весь порядок работы.
«Алгоритм может не включать страницу в поиск, если у нее мало шансов оказаться востребованной пользователями. Так может произойти, например, если страница дублирует уже известные роботу страницы, не содержит контента, либо ее контент не совсем соответствует запросам пользователей. Это автоматический регулярный процесс, поэтому решение алгоритма о включении в поиск конкретной страницы может измениться».
Источник: справка Вебмастера «Малоценные или маловостребованные страницы».
- Это не нарушение. «Если у сайта есть такие страницы, это не означает, что у него есть нарушения и ограничения в ранжировании». Ограничения проверяют отдельно, на странице «Оптимизация сайта → Безопасность и нарушения».
- Сайт от этого не проседает. «Число исключенных таким образом страниц негативно не влияет на ранжирование сайта».
- Квот нет. «У Яндекса нет квот на количество страниц, попадающих в индекс. Любое количество страниц, которые алгоритм признает полезными пользователям, будут проиндексированы».
- Решение пересматривается. «Алгоритм проверяет все страницы регулярно, почти каждый день». Страница может выпасть и вернуться без правок, потому что «релевантность страниц в поиске также может изменяться, даже если их содержимое осталось прежним».
- Но пересматривается старая копия. «Алгоритм не выполняет повторного индексирования страниц, а проверяет тот контент страниц, который на этот момент есть в базе». Правки на сайте алгоритм учтёт только после того, как робот заново скачает страницу.
- Исключение не окончательное. Исключённые как маловостребованные страницы «доступны и могут участвовать в поиске». Если такие страницы вам не нужны, справка советует запретить их индексирование.
Практический вывод: статус — это диагностика, а не приговор. Повод для работы — не сам факт исключения, а нужные страницы среди исключённых: карточки с продажами, услуги, статьи под реальный спрос.
Малоценная и маловостребованная: два диагноза под одним статусом
В интерфейсе это один статус, и в выгрузке у него один код — LOW_DEMAND. Справка при этом делит такие страницы на два типа, и лечатся они по-разному.

| Тип | Определение по справке | Что проверять |
|---|---|---|
| Малоценная | «Страница может быть признана малоценной, если она является дублем или не содержит видимый роботу контент» | Заголовки title, h1, h2; не отдан ли важный контент картинкой, JS-скриптами или через iframe; HTML-код страницы в инструменте «Проверка ответа сервера» |
| Маловостребованная | «Если страница без ошибок в HTML-коде, содержит контент, но в поиске нет пользователей и запросов, на которые она могла бы ответить, страница может быть исключена из поиска как маловостребованная» | Под какие запросы страница; есть ли спрос в «Подборе слов»; по каким запросам у сайта уже есть показы в «Статистике поисковых запросов» |
Ключевая фраза про маловостребованные страницы стоит в справке перед определением: «Алгоритм оценивает каждую страницу, будет ли она показана по запросам на тех позициях, где пользователь сможет ее найти». Отсюда следует: мало, чтобы запрос существовал в Вордстате. Странице нужен шанс оказаться на видимых позициях. Если по запросу сильные конкуренты или на вашем же сайте есть более подходящая страница, страница может стать маловостребованной при живом спросе.
Почти-дубли попадают в маловостребованные
Важная деталь из раздела вопросов и ответов той же справки: страницы с почти одинаковым содержимым дублями не признаются, но конкурируют друг с другом.
«Содержимое страниц может незначительно различаться или меняться динамически, из-за чего такие ссылки не могут быть признаны дубликатами. Однако из-за схожести контента страницы могут конкурировать между собой в поиске и дублировать друг друга, и одна из них будет наименее востребованной».
Источник: справка Вебмастера, раздел «Вопросы и ответы».
Там же объяснено, почему из двух похожих страниц в поиске остаётся одна: алгоритм «оставляет в поиске только одну, которая, по его мнению, является более релевантной». По сути это каннибализация на уровне индекса. Типичные примеры — варианты товара, отличающиеся цветом, страницы «город + услуга» с одинаковым текстом, пересечения фильтров с теми же товарами.
С чем статус путают: «Дубль», «Неканоническая» и «Малополезный контент»
Явные дубли у Яндекса получают собственные статусы, а «Малополезный контент» — вообще не статус страницы, а нарушение. Перед разбором проверьте, с чем вы имеете дело. Статусы и коды ниже — из справки «Страницы в поиске».
| Что видите | Код в выгрузке | Что это значит по справке | Что делать |
|---|---|---|---|
| Малоценная или маловостребованная страница | LOW_DEMAND | Алгоритм решил не включать страницу в поиск: у неё мало шансов оказаться востребованной | Найти причину по порядку из раздела ниже |
| Дубль | DUPLICATE | «Страница дублирует уже представленную в поиске страницу сайта» | Указать предпочтительный адрес 301-редиректом или rel="canonical" |
| Неканоническая | NOT_CANONICAL | Страница проиндексирована по адресу, указанному в rel="canonical" | Проверить, верно ли указан canonical |
Исключена по Clean-param | CLEAN_PARAMS | Страница исключена после обработки директивы Clean-param | Ничего, если параметр действительно незначащий |
| Неглавный адрес сайта | NOT_MAIN_MIRROR | «Страница относится к неглавному адресу сайта» | Проверить главный адрес и редиректы на него |
| Малополезный контент | не статус страницы, а нарушение | «информация, которая не несет дополнительную ценность пользователю и не решает его задачу» | Смотреть «Оптимизация сайта → Безопасность и нарушения» |
Определение малополезного контента — из справки о нарушении. Когда осенью 2023 года вебмастера стали спрашивать, связаны ли нарушение и статус, сотрудник Яндекса ответил коротко:
«„малополезный контент“ и „маловостребованные страницы“ между собой не связаны».
Источник: ответ platon (сотрудник Яндекса) от 6 октября 2023 года в комментариях к посту «Малополезный контент: почему может быть обнаружено такое нарушение» в блоге Вебмастера.
В тех же комментариях видно, откуда путаница: сокращением «МПК» вебмастера называют нарушение, а не статус. В переписке с подрядчиком или клиентом называйте статус полностью.
Откуда взялся статус
До февраля 2021 года на этом месте в таблице статусов справки стояла «Недостаточно качественная» с кодом BAD_QUALITY и расшифровкой «Страница считается некачественной. Ознакомьтесь с рекомендациями» (снимок справки от 25 декабря 2020 года). В снимке от 7 марта 2021 года на её месте уже «Малоценная или маловостребованная страница» с кодом LOW_DEMAND. По данным Searchengines.guru, раздел справки о новом статусе появился примерно 19 февраля 2021 года (новость от 11 марта 2021 года).
Яндекс сменил формулировку с «качества» на «спрос»: low demand и значит «низкий спрос». Практический вывод: разбирать такие страницы стоит через дублирование и востребованность, а не через абстрактное «качество текста».
Что описано в патентах Яндекса
Какой моделью присваивается статус, Яндекс не раскрывает. Но среди действующих патентов компании есть четыре, которые вместе описывают путь страницы от обхода до вытеснения из индекса. Патент не равен внедрению: ниже — что защищает формула и что сказано в описаниях. Связь этих патентов со статусом в Вебмастере Яндекс не подтверждал, это наша сводная модель. Как отличать формулу от примеров в описании, мы разбирали в статье о том, как читать патенты Яндекса.
| Патент | Этап | Что описано | Статус по ФИПС на 07.10.2026 |
|---|---|---|---|
| RU2634218C2 (US10572550B2), заявка 24.07.2014 | Обход | Порядок обхода новых URL по ожидаемой популярности и её ожидаемому снижению | Действует |
| RU2714601C1, заявка 14.09.2018 | Индексация | Оценка значимости после обхода; выше порога — индексирование в реальном времени, ниже — отложенное | Действует |
| RU2720954C1 (US11194848B2), заявка 13.12.2018 | Отбор в индекс | Выбор документов для индекса по значимости в пересчёте на размер документа в байтах | Действует |
| RU2733482C2 (US10891340B2), заявка 16.11.2018 | Обновление индекса | Части индекса с большой долей неактивных документов обновляются первыми; неактивные — без показов или взаимодействий за период | Действует |
Отбор в индекс: значимость в пересчёте на размер
Патент RU2720954C1 «Способ и система построения поискового индекса с использованием алгоритма машинного обучения» начинается с наблюдения, которое знакомо любому владельцу большого сайта:
«в поисковом индексе сервера поисковой системы имеется большое количество документов, которые редко показываются пользователям»
Источник: RU2720954C1, абзац [0012] описания.
Формула защищает способ выбора документов для индекса. Для каждого документа определяется параметр значимости — полезность документа как результата поиска на основе пользовательских взаимодействий; по п. 3 формулы взаимодействия могут быть прошлыми или прогнозируемыми. Затем значимость соотносится с размером. В описании это записано как q(di) = p(di) / f(size(di)), где size(di) «является размером i-го документа в байтах» ([0081]–[0082]). Упрощённый вариант — qi = g(pi / sik), где «k является константой, g является логарифмической функцией, выбранной вручную» ([0085]). В американской версии US11194848B2 ранг документа зависит от «ratio of the respective value parameter to the respective size of the respective document» (п. 4 формулы).
Признаки, по которым в описании предлагается оценивать документы (абзац [00215], перечень неограничивающий):
- веб-граф: входящие и исходящие ссылки, PageRank, HITS;
- статистика документа: число слов, число слов в анкорах входящих ссылок, «количество зеркальных копий документа»;
- характеристики URL: глубина, число посещений, «количество косых черт в URL»;
- тип содержимого: новости, статья энциклопедии, официальный сайт;
- клики: вероятность клика, первый и последний клик, клик с долгим пребыванием, вероятность пропуска, среднее время пребывания;
- время создания и изменения документа.
В абзаце [0076], где разбирается один из подходов разработчиков, среди признаков названы и заходы не из поиска: «историческое количество посещений упомянутого цифрового документа из источников, отличных от поисковой системы (например, путем ввода URL-адреса документа в адресной строке браузера, или посещения через ссылки, содержащиеся в других документах)».
Индексация: сразу или в отложенную очередь
В патенте RU2714601C1 «Способ и сервер для индексирования веб-страницы в индексе» после обхода модель машинного обучения оценивает полезность страницы как поискового результата. По п. 1 формулы, «если оценка значимости находится ниже порога сортировки, веб-страница добавляется к очереди отложенного индексирования веб-страниц». Признаки перечислены в п. 17: «время создания веб-страницы», «число визитов на URL веб-страницы», «число входящих гиперссылок на веб-страницу», «число исходящих гиперссылок с веб-страницы», «тип содержимого веб-страницы». Порог не фиксирован: по п. 15 он «зависит от доступного количества вычислительной мощности для выполнения индексирования в режиме реального времени».
Обход: прогноз популярности по шаблону URL
Формула RU2634218C2 «Способ определения последовательности просмотра веб-страниц и сервер, используемый в нем» защищает порядок обхода новых страниц по оценке «параметра ожидаемой популярности и параметра ожидаемого снижения популярности». Модель обучается на поведении страниц того же шаблона адреса: по п. 7 среди признаков, например, «количество переходов ко всем URL-адресам в шаблоне Р». Отсюда следует: в такой модели новая страница в разделе, куда никто не ходит, получает низкий приоритет ещё до того, как робот её скачает.
Обновление индекса: неактивные документы
В US10891340B2 и его российском аналоге RU2733482C2 «Способ и система для обновления базы данных поискового индекса» индекс разбит на части, а документы в каждой делятся на активные и неактивные. Неактивные по п. 12 формулы — «документы, с которыми не было пользовательских взаимодействий в ответ на любой запрос в течение заранее определенного периода времени» и «документы, которые не были представлены в ответ на любой запрос в течение заранее определенного периода времени». Части, где доля активных документов ниже, обновляются в первую очередь, а помеченные неактивными документы, по описанию, «may be deleted» при последующих обновлениях этих частей.
Сводная модель: два выхода из поиска
Если сложить четыре патента, путь страницы выглядит так. Это наша модель, а не описание работы Яндекса.
- Обнаружение: ссылки, Sitemap, обход по счётчикам Метрики, IndexNow.
- Обход в порядке ожидаемой популярности (RU2634218C2).
- Оценка значимости и выбор очереди индексирования (RU2714601C1).
- Первый выход — отбор в индекс по значимости в пересчёте на размер (RU2720954C1). Страница скачана, но в поиск не включена. По смыслу это совпадает с тем, что Вебмастер показывает статусом «Малоценная или маловостребованная страница».
- Второй выход — при обновлении индекса документы без показов и взаимодействий за период становятся неактивными и могут быть удалены (US10891340B2).
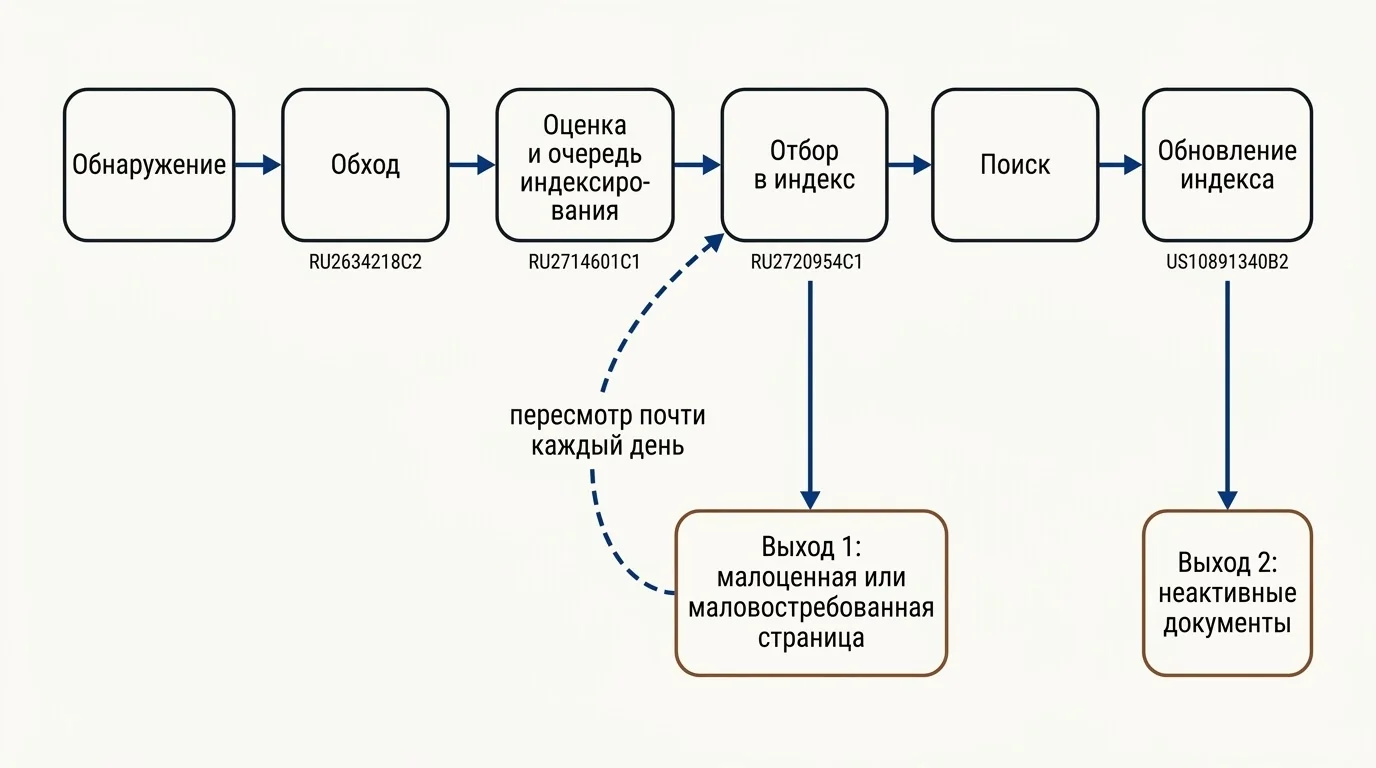
Совпадает главное: и справка, и патенты говорят о прогнозе востребованности, а не о «плохом качестве». Показывает ли Вебмастер второй выход тем же статусом, неизвестно. Остальные патенты по индексации и ранжированию собраны в нашем своде патентов Яндекса для SEO.
Практические выводы из модели:
- Почти все признаки в этих патентах описывают спрос и взаимодействия: визиты, в том числе не из поиска, ссылки, показы, клики. Страница, о которой никто не знает, проигрывает отбор независимо от качества текста.
- Число зеркальных копий — отдельный признак. Как именно он влияет, в патенте не сказано, но сам факт, что копии считаются, — ещё один довод склеивать дубли.
- Размер в формуле — размер самого документа в байтах. Про внешние CSS, JS и картинки там ничего нет (подробнее в разделе о мифах).
Откуда берутся такие страницы и что с ними делать
Почти все причины сводятся к трём: адресов больше, чем сущностей; страниц больше, чем спроса; робот не видит, что на странице есть.
| Причина | Какой статус увидите | Что делать |
|---|---|---|
| UTM-метки, сортировки, идентификаторы сессий | Обычно «Дубль» или «Исключена по Clean-param» | Clean-param или «Индексирование → Настройка GET-параметров», canonical на основную версию |
| Адреса с www и без, http и https | «Неглавный адрес сайта» | 301-редирект на главный адрес |
| Варианты товара с почти одинаковым текстом | Маловостребованная: по справке почти-дубли «не могут быть признаны дубликатами» | canonical на основную карточку; отдельный URL оставлять, если у варианта есть собственный спрос |
| Фильтры и теги без спроса, пустые листинги | Маловостребованная | Закрыть через noindex или Disallow; открытыми оставить комбинации с частотностью |
| Страницы «город + услуга» и региональные поддомены с одинаковым текстом | Риск маловостребованности (наш вывод из правила о почти-дублях) | Уникальное локальное содержание: цены, адреса, сроки, примеры работ — или одна общая страница |
Основной текст в JS, в iframe или картинкой | Малоценная: робот не видит контент | Отдавать основной текст в HTML; проверять в «Проверке ответа сервера» |
| Новые статьи, повторяющие старые | Дубль или маловостребованная | Обновлять старую статью; с повтора — 301 на неё |
Удалённые или закрытые страницы (403, 404, noindex) всё ещё в списке | Маловостребованная, пока робот не переобойдёт | Подождать переобхода или запретить в robots.txt: тогда ссылки пропадут из базы «в течение двух недель» |
| Страница с контентом, но не под запросы | Маловостребованная | Переписать под реальные формулировки запросов или объединить несколько слабых страниц в одну |
Про региональные поддомены справка о дублях говорит прямо: «страницы на региональных поддоменах с одинаковым содержимым не считаются дублями» (справка «Дублирование страниц»). Статусом «Дубль» их не отметят, но конкурировать как почти-дубли они могут.
Дубли вредны и без связи со статусом. Справка «Чем плохи дубли» перечисляет: «на обход дублей тратится время и ресурсы сайта и Поиска», «Новые страницы могут индексироваться медленнее», «Дубли могут конкурировать между собой в поиске», а робот может «посчитать дублем и исключить из поиска страницу, которая является целевой и важна для сайта».
Для интернет-магазинов в справке о статусе есть отдельный совет: «Если у вас интернет-магазин, вы можете использовать Яндекс Товары и подключение к Маркету с помощью YML-фида. Это поможет Яндексу получать о страницах сайта более полную информацию и может улучшить их представление в результатах поиска».
Порядок разбора исключённых страниц
Работайте с шаблонами, а не с отдельными адресами: одна правка шаблона закрывает сотни страниц.
- Выгрузите список. В Вебмастере откройте «Индексирование → Страницы в поиске», раздел исключённых страниц, и выгрузите данные в XLS или CSV. В выгрузке последних изменений есть поля
url,httpCode,status,target,lastAccess,titleиevent. ОтфильтруйтеLOW_DEMAND. - Сгруппируйте по шаблонам URL: карточки, фильтры, теги, статьи, пагинация, служебные страницы. Отметьте группы, где есть страницы, которые должны приносить трафик.
- Для каждой группы задайте четыре вопроса по порядку. Первый ответ, который требует действия, и определяет, что делать.
- Это дубль другой страницы? Да — склеить: 301, canonical,
Clean-paramили «Настройка GET-параметров». Одна сущность и один интент — один URL. - Странице вообще место в поиске? Нет — служебные страницы и пустые фильтры закрыть через
noindexилиDisallow, ненужное удалить: 404 или 410 либо 301 на близкую страницу. - Робот видит основной контент? Нет — отдать текст в HTML, а не только через JS,
iframeили картинку. - Под страницу есть спрос? Нет — доработать под реальные запросы или объединить с более сильной страницей. Спрос справка советует искать в «Подборе слов», «Статистике поисковых запросов» и «Управлении группами».
- Это дубль другой страницы? Да — склеить: 301, canonical,
- Найдите дубли и тонкие страницы краулером. Выгрузку Вебмастера удобно сопоставить с обходом сайта, например в техническом аудите xyx.su: так видно, какой шаблон порождает одинаковые заголовки и пустые листинги. Какие страницы отвечают на один интент, покажет кластеризация запросов.
- Сообщите роботу об изменениях. Алгоритм проверяет копию из базы, поэтому без повторного обхода правки не учтутся. Ключевые адреса отправьте в «Индексирование → Переобход страниц»: лимит там ограничен и, по справке, «обновляется ежедневно». Для большого объёма справка рекомендует «Обход по счетчикам»; подойдёт и IndexNow, но он, по справке, «не гарантирует, что переданные страницы будут проиндексированы». После правки обновите
lastmodв Sitemap. - Сравнивайте с контрольной группой. Правьте часть однотипных страниц и сравнивайте с такой же частью без правок. Так вы отличите эффект правки от обычных колебаний, о которых пишет справка.
- Проверьте позиции вернувшихся страниц. Включение в поиск не равно трафику. Отслеживайте, по каким запросам и на каких позициях показываются вернувшиеся страницы, например в проверке позиций.
Как не плодить новые исключения
- Один интент — один URL. Перед созданием страницы проверьте, нет ли на сайте страницы под тот же кластер запросов.
- Фильтры и теги открывайте для индексации, только если под комбинацию есть спрос.
- Обновляйте старые материалы вместо новых публикаций на ту же тему.
- Связывайте новую страницу с сайтом сразу: ссылка из раздела или блока новинок, Sitemap, IndexNow. По справке, «Обход по счетчикам Метрики ускоряет индексирование сайта».
- Приводите на новую страницу живых посетителей с первых дней: рассылка, соцсети, внутренние блоки. В патентах визиты на URL и заходы не из поиска перечислены среди признаков (RU2714601C1, п. 17; RU2720954C1, [0076]). Как на них реагирует реальный поиск, Яндекс не раскрывает, но вреда от настоящих посетителей нет.
- Не накручивайте визиты. «Имитация действий пользователей» — нарушение. Справка предупреждает: «Эти ограничения могут влиять на ранжирование всего сайта или его разделов».
- Держите важное близко к главной. Глубина URL и число слешей названы среди признаков в описании RU2720954C1. Веса не раскрыты, но короткий путь от главной полезен и для обхода, и для пользователей.
Два мифа: пороги в процентах и «бюджет индексации»
«Если таких страниц больше N%, сайт проседает»
Порог встречается в разных вариантах, от 10 до 40%, но данных под ним нет. Справка говорит обратное: «Число исключенных таким образом страниц негативно не влияет на ранжирование сайта». Большая доля исключённых страниц — симптом: адресов на сайте больше, чем сущностей и спроса. Смотреть нужно не на процент, а на состав: есть ли среди исключённых страницы, которые должны приносить трафик, и не растёт ли их число после релизов.
«Сожмите CSS и JS, чтобы сэкономить бюджет индексации»
«У Яндекса нет квот на количество страниц, попадающих в индекс», — это прямая цитата из справки. В RU2720954C1 размер — это размер самого документа в байтах, и при равной значимости лёгкий документ в такой модели выигрывает. Но внешние CSS, JS и картинки в формуле не упоминаются. А насколько сильно размер штрафует документ, зависит от константы k и вручную выбранной функции g, которые патент не раскрывает.
Практический вывод: вычищать раздутый HTML массовых шаблонов, например инлайн-скрипты и повторяющиеся блоки, разумно и ради скорости, и в логике этой модели. Ожидать, что минификация внешних файлов вернёт страницы в поиск, оснований нет. Реальная экономия обхода — в склейке дублей: на них, по справке, «тратится время и ресурсы сайта и Поиска».
Сколько ждать возврата
Сроков Яндекс не называет. Из справки следуют два условия: алгоритм пересматривает страницы «почти каждый день», но по копии в базе, то есть сначала робот должен заново скачать исправленную страницу. «Переобход страниц» и IndexNow ускоряют повторное скачивание, а решение о включении остаётся за алгоритмом. Публичные наблюдения о сроках сильно расходятся и сделаны без контрольных групп, поэтому мы их не приводим. Надёжнее мерить по своему сайту: дата правки, дата переобхода из поля lastAccess, дата возврата в поиск.
Частые вопросы
Влияет ли большое число малоценных страниц на позиции сайта?
По справке Яндекса — нет: «Число исключенных таким образом страниц негативно не влияет на ранжирование сайта». Проблема в другом: если среди исключённых оказались нужные страницы, вы теряете их трафик. А дубли, по справке, замедляют индексирование новых страниц.
Может ли страница вернуться в поиск без правок?
Да. Алгоритм проверяет страницы «почти каждый день» и может «исключать страницы из поиска и снова возвращать их», даже если содержимое не менялось: меняются результаты поиска и релевантность. Если нужная страница выпадает регулярно, это повод сделать её заметно лучше конкурентов по своему запросу, а не ждать.
Почему страницы с 404 или noindex всё ещё числятся маловостребованными?
Алгоритм работает с копией в базе. Справка объясняет: если страницы раньше отвечали кодом 200, алгоритм «может проверять их до тех пор, пока робот не посетит страницы повторно и не отследит изменения в коде ответа». Ускорить удаление можно запретом в robots.txt: тогда ссылки «автоматически пропадут из базы робота в течение двух недель».
Нужно ли убирать исключённую страницу из sitemap.xml?
Справка о статусе этот вопрос не разбирает. Практический вывод: если страница нужна и вы её дорабатываете, оставьте её в Sitemap и обновите lastmod после правки. Если не нужна, закройте её от индексации, как советует справка, и уберите из Sitemap, чтобы карта не противоречила запрету.
Чем статус отличается от «Малополезного контента» и фильтров за тексты?
«Малополезный контент» и «Использование SEO-текстов» — нарушения, описанные в справке Вебмастера; о переоптимизированных текстах подробно — в нашей статье про «Баден-Баден». Статус исключения — решение об индексе, а не нарушение: «Если у сайта есть такие страницы, это не означает, что у него есть нарушения и ограничения в ранжировании». Ограничения проверяют на странице «Оптимизация сайта → Безопасность и нарушения».
Почему из двух похожих страниц в поиске только одна?
Справка: «Возможно, похожие страницы отвечают на один и тот же запрос пользователя, поэтому алгоритм оставляет в поиске только одну, которая, по его мнению, является более релевантной». Решите сами, какая страница главная, и склейте вторую с ней или разведите их по разным запросам.
Источники
- Справка Яндекс Вебмастера. Малоценные или маловостребованные страницы. Проверено 07.10.2026.
- Справка Яндекс Вебмастера. Страницы в поиске: статусы и коды, выгрузка. Проверено 07.10.2026.
- Справка Яндекс Вебмастера. Чем плохи дубли и Дублирование страниц. Проверено 07.10.2026.
- Справка Яндекс Вебмастера. Малополезный контент, Использование SEO-текстов и Имитация действий пользователей. Проверено 07.10.2026.
- Справка Яндекс Вебмастера. Переобход страниц, IndexNow, обход по счётчикам Метрики, Настройка GET-параметров, Clean-param, Проверка ответа сервера. Проверено 07.10.2026.
- Блог Яндекса для вебмастеров. Малополезный контент: почему может быть обнаружено такое нарушение, 05.10.2023; ответ сотрудника Яндекса в комментариях от 06.10.2023.
- Архив справки «Страницы в поиске»: снимки 25.12.2020 и 07.03.2021.
- Searchengines.guru. В Яндекс.Вебмастере появился новый статус «Малоценная или маловостребованная страница», 11.03.2021.
- Патент RU2720954C1 «Способ и система построения поискового индекса с использованием алгоритма машинного обучения»: заявка 13.12.2018, опубликован 15.05.2020, действует по реестру ФИПС на 07.10.2026. Американский аналог — US11194848B2.
- Патент RU2714601C1 «Способ и сервер для индексирования веб-страницы в индексе»: заявка 14.09.2018, опубликован 18.02.2020, действует по реестру ФИПС на 07.10.2026.
- Патент RU2733482C2 «Способ и система для обновления базы данных поискового индекса»: заявка 16.11.2018, опубликован 01.10.2020, действует по реестру ФИПС на 07.10.2026. Американский аналог — US10891340B2.
- Патент RU2634218C2 «Способ определения последовательности просмотра веб-страниц и сервер, используемый в нем»: заявка 24.07.2014, опубликован 24.10.2017, действует по реестру ФИПС на 07.10.2026. Американский аналог — US10572550B2.
Комментарии
Оставить комментарий